Vision-Action Data Factory
Генерация данных для обучения роботов
Генерация данных для обучения роботов
 @conn4445
31 августа
Добрый день, допустимо ли, чтобы generate_dataset.py создавал директорию извлечённых кадров и ссылался на неё. Есть ли у нас право на любую нормализацию изображений?
2
 @ferry3563
1 сентября
Добрый день! Создавать директории для кадров можно при условии, что это будет полностью воспроизводимо. Нормализация изображений разрешается также при условии полной воспроизводимости
1
 @hand8710
3 сентября
Добрый день! Подскажите верно ли что в инференсе ЛБ участвует только прогон загруженных весов? и соответственно вопрос какое ограничение на бюджет генерации датасета и обучения, если эта проверка будет делаться отдельно только для топ N участников в конце.
0
@ferry35633 сентября
Добрый день! Для прогона бенчмарка используются только загруженные веса, все верно. По ограничениям на бюджет генерации и обучение: а на какие объемы вы ориентируетесь?
0
@hand87105 сентября
Добрый день, скорее понимать масштаб условно если обработка данных занимает еше условно час или несколько на такой же машине (тут у меня просто нет возможности на аналогичном железе проверить, но условно на одной H100 скажем если я буду генерить датасет например 10-20ч например, это ок ?)
0
@hand87103 сентября
Добрый день! Вопрос по параметрам обучения:
сайт говорит о фиксированных параметрах и compute budget, а предоставленный participant README и сами конфиги прямо разрешают изменять LR, steps, batch и выбирать full/LoRA.
Что является истиной ?
0
@ferry35633 сентября
Добрый день! Стратегия обучения VLM может зависеть от характера данных, которые вы генерируете. Поэтому по вопросу разрешенных параметров просим ориентироваться на readme и конфиги
0
 @renner4544
3 сентября
Привет, а можно узнать почему падает сабмит? Попробовал по разному закинуть, 4 последних сабмита упали на "12. Статус работы скрипта оценки решения", скорее всего это моя ошибка, но боюсь так без логов тяжело отладить.
Команда renner45448572
4
 @hermann5422
6 сентября
аналогичная проблема
0
@hand87105 сентября
Ни у кого не было проблем с отправкой на 12том статусе ? заливал абсолютно одинаковые решения с разницей только в весах моделей и последние 2 дня стабильно падает решение, единственная разница все упавшие самбиты после сжатия были мизерно больше по весу, мб есть какое-то скрытое ограничение на размер архива или еше что-то ?
1
@renner45446 сентября
1 в 1 проблема, уже пробовал просто заменить safetensors от бейзлайна , и даже так падает
0
@hermann54225 сентября
Добрый день, допустимо ли использовать библиотеки с лицензией AGPL-3.0?
0
@hermann54226 сентября
Добрый день, подскажите, контрольный запуск полного пайплайна для финалистов тоже будет выполняться с учетом ограничения 210 минут?
0
 @blick8624
7 сентября
Добрый день! Запуск весов финалистов займет +- столько же времени, как и текущий, если вы финалист, вам в любом случае будет необходимо предоставить нам полное решение, включая весь код и веса.
0
@hand87106 сентября
ну да, проверяющая система сломалась просто, падает и то что раньше проходило
0
@conn44457 сентября
Обучение action expert задано числом шагов (steps: 30000) при batch_size: 4. В lerobot batch_size — это батч на процесс, поэтому при запуске на N GPU эффективный батч равен 4 × N, а число обработанных примеров растёт в N раз при том же числе шагов. Означает ли «fixed compute budget», что обучение должно выполняться на одном GPU (эффективный батч 4), или допустим многокарточный запуск? В action_expert/train_config.json число GPU не
сохраняется, поэтому по сабмиту эти случаи неразличимы.
1
@blick86247 сентября
Здравствуйте! Обучать вы можете на любом GPU и на любом их количестве.
0
@conn44457 сентября
как соеденены между собой 16 × NVIDIA H100 на вашем сервере? можем ли мы шарить веса моделей между ними?
1
@blick86247 сентября
Здравствуйте! Инференс ваших весов всегда проводится на 1хH100
0
@hand87108 сентября
Решение зависло на шаге 6 уже несколько часов
0
 @haley5191
9 сентября
Опять все падает на этапе "12. Статус работы скрипта оценки решения", даже тот сабмит, который раньше проходил, целый день убил, пытаясь у себя найти проблему... Когда ожидается фикс и сколько еще раз такое будет повторяться?)
1
@haley51919 сентября
заработало наконец-то
0
@hermann542212 сентября
Добрый день. Подскажите, лимит 210 минут относится к полному прогону пайплайна (генерация датасета + дообучение VLM + обучение action expert) или к отдельным этапам?
На сколько понимаю, сейчас generate_dataset.py не запускается т.к annotations.jsonl передаются в готовом виде
0
@ferry356312 сентября
Добрый день! Генерация датасета на данном этапе не входит в прогон и не запускается. Но в конце соревнования будем запускать для проверки решений финалистов
0
@hermann542212 сентября
Есть ли ограничения на размера загружаемого .zip?
0
@ferry356312 сентября
Добрый день! Да, есть ограничение в 5ГБ
0
@hermann542215 сентября
Спасибо, а для проверки финалистов используется тот же .ZIP до 5 ГБ или можно отдельно передать дополнительные файлы (например, веса открытых моделей или зависмости, которых нет в окружении)?
0
@conn444514 сентября
Добрый день! Уточните, пожалуйста, по второй стадии обучения (action expert). Распространяется ли ваш ответ про разрешённые параметры обучения (ориентироваться на readme и конфиги) и на эту стадию: можно ли менять число шагов, размер батча и learning rate обучения action expert, или параметры второй стадии фиксированы, как указано на сайте («parameters and compute budget for both training stages»)? Архитектуру и датасет LIBERO мы не трогаем.
1
@ferry356316 сентября
Добрый день! Просим ориентироваться на readme и конфиги
0
@hermann542217 сентября
Добрый день, для проверки финалистов используется тот же .ZIP до 5 ГБ или можно отдельно передать дополнительные файлы (например, веса открытых моделей или зависмости, которых нет в окружении)?
0
@ferry356321 сентября
Добрый день! Для решений финалистов действует то же ограничение в 5ГБ
0
 @dach5656
17 сентября
Добрый день!
Можно ли менять configs/vlm_sft.yaml (learning rate, число эпох, заморозка vision tower)? В репозитории написано «free to edit», а в правилах сказано, что параметры и вычислительный бюджет обеих стадий фиксированы. Что из этого имеет приоритет на контрольном прогоне?
0
@ferry356321 сентября
Добрый день! Просим ориентироваться на readme и конфиги из репозитория - у них приоритет
0
@conn444520 сентября
Можно ли в annotations.jsonl ссылаться на кадры датасета HuggingFaceVLA/
libero (v3.0), который используется для обучения action expert? То есть включать в датасет для VLM вопросы по кадрам обеих камер LIBERO? Или для VLM-датасета допустимы только четыре источника со вкладки Data?
2
@ferry356321 сентября
Добрый день! Нет, ссылаться на LIBERO при генерации датасета для VLM не допускается
0
@conn444520 сентября
Допустима ли генеративная правка кадров (inpainting фона/текстур) как часть generate_dataset.py
1
@ferry356321 сентября
Добрый день! Допустима в случае, если она будет полностью воспроизводима
0
@conn444522 сентября
Здравствуйте, допустимо ли в vla_libero.yaml менять train_expert_only и freeze_vision_encoder (обучать VLM/энкодер на второй стадии)?
0
@blick862424 сентября
Здравствуйте! Да, в vla_libero.yaml можно менять train_expert_only и freeze_vision_encoder, в том числе дообучать VLM и визуальный энкодер на этапе VLA. Шаблон конфигурации разрешено редактировать.
Учитывайте, что разморозка увеличит расход видеопамяти и время обучения. После изменения настроек проверьте, что итоговый submission корректно загружается и проходит локальный self-check.
0
 @schoen1993
22 сентября
Здравствуйте, как именно считается VLA (среда/сьюты, chunked-режим, число эпизодов)?
1
@blick862424 сентября
Здравствуйте! В открытом self-check VLA запускается в симуляторе LIBERO на libero_spatial: 10 задач, по умолчанию по одному эпизоду на задачу. Для каждой задачи считается доля успешных эпизодов, затем берётся среднее по задачам с равным весом. Число эпизодов для своей проверки можно изменить в конфиге.
В шаблоне обучения политики указаны chunk_size: 50 и n_action_steps: 50. Это параметры модели, а не описание условий официальной оценки. Состав сред, режим исполнения чанков и число эпизодов официального прогона мы не раскрываем. Поэтому результат self-check следует использовать для сравнения своих экспериментов, а не как точный прогноз результата в лидерборде.
0
 @trantow2337
23 сентября
Здравствуйте! Я хотел бы задать два вопроса:
1) Датасет libero большой. Ранее вы запрещали использовать для обучения VLM. Можно ли для обучения VLA использовать весь датасет? Сейчас в particapants.zip yaml предполагает использование лишь части датасета. Можно ли поменять конфиг?
2) Ограничение 210 минут распространяется на весь пайплайн (построение ShareGPT, установка зависимостей, обучение) или только на generate_dataset.py – построение датасета?
Вам уже задавали этот же вопрос, но вы ответили:
"Генерация датасета на данном этапе не входит в прогон и не запускается. Но в конце соревнования будем запускать для проверки решений финалистов"
Интересует, как всё-таки будет для финалистов, чтобы сразу понимать ограничения.
2
@blick862424 сентября
Здравствуйте!
Да, для обучения VLA можно использовать весь доступный датасет LIBERO v3.0 и менять размер выборки в vla_libero.yaml. Ранее озвученное ограничение на использование LIBERO для отдельного обучения VLM сохраняется.
Сейчас generate_dataset.py в прогоне не запускается. Лимит 210 минут действует только для прогона ваших весов и получения метрик для лидерборда. У финалистов должно быть полностью воспроизводимое решение, мы не ставим для финалистов явного ограничения времени на воспроизведение их результатов, но это время должно быть разумным, т.е если для воспроизведения ваших результатов понадобится две недели или месяц, то это не очень хорошо.
0
 @pacocha6731
25 сентября
Подскажите, пожалуйста: учитывается ли VLA-компонента в текущем публичном лидерборде, и получали ли какие-либо сабмиты ненулевой VLA? У нас три разных action-эксперта (self-check libero_spatial 0.16–0.46) дают на ЛБ ровно одинаковый скор, отличающийся только VLM-частью.
5
 @hamill5759
27 сентября
У нас та же картина, диагностический сабмит, отличающийся от предыдущего ТОЛЬКО путями в конфигах actionexpert (vlmmodelname/tokenizername, включая путь из демо-фикстуры), дал Score, совпадающий до 4-го знака. При этом локально даёт сильно больше. Очень просим подтвердить, зачитывается ли VLA-компонента в текущем LB
1
@dach565626 сентября
А есть где-то запись вебинара с 25 сентября?
8
@hamill575927 сентября
Здравствуйте! Подтверждаете ли, что в текущем публичном лидерборде VLA-компонента Score равна нулю у всех сабмитов, включая baseline (9.90909 = 40·0.2477 — чистое VLM-разложение)? Если да — планируется ли фикс до конца соревнования? Если VLA зачитывается, но скрытый бенч даёт SR≈0 всем — достаточно подтверждения «это ожидаемое поведение», без деталей протокола.
2
@blick862428 сентября
Здравствуйте, мы посмотрим логи и сообщим по существу.
0
@hamill575927 сентября
Здравствуйте! При контрольном прогоне решений финалистов будет ли у generated ataset.py доступ к сети (интернет / HuggingFace), или решение обязано работать полностью офлайн в пределах 5 ГБ ZIP? Влияет на выбор моделей разметки: заранее вендорить веса в архив или закладывать скачивание.
0
@hamill575927 сентября
Здравствуйте! На каком железе будет запускаться контрольный прогон финалистов — генерация датасета (число и тип GPU, CPU/RAM) и инференс весов? Про инференс знаю «1×H100», интересует именно стадия generate dataset.py, чтобы правильно оценить время воспроизведения.
0
@hamill575927 сентября
Как выбираются 3 финальных решения: автоматически лучшие по LB из моих сабмитов, или я указываю конкретные? Будут ли финальные сабмиты переоценены контрольным прогоном (может ли скор измениться относительно LB)?
0
 @blanda7513
28 сентября
Добрый день. 3 финальных решения выбираются участником вручную, но это не обязательная манипуляция. В случае отсутствия ручного выбора, выбор будет сделан автоматически (3 решения с лучшим паблик скором). На этапе формирования привата, для 3 выбранных решений будет расчитан приватный скор и решение команды с лучшим приватным скором из 3 попадет на приватный лидерборд.
0
@hamill575927 сентября
Возможно ли получить лог прогона своего сабмита (этапы 12+, загрузка action_expert) — хотя бы для финалистов после подведения итогов? Для диагностики воспроизводимости
0
@blanda751328 сентября
Добрый день. Логи доступны только для "упавших" сабмитов.
0
@schoen199329 сентября
Добрый день.
1) Где посмотреть запись вебинара?
2) Про VLA=0 для всех вы подтверждаете? Или это отключено сейчас, для снижения нагрузки, а на приватном этапе - будет по правилам.
1
@ferry356330 сентября
❗️Уважаемые участники!
В скрипте оценки ваших решений по задаче Vision-Action Data Factory был обнаружен баг, из-за которого не засчитывались метрики на VLA-бенчмарках. Как указано в правилах конкурса, эти метрики имеют вес 0.6 в итоговом результате.
Баг был исправлен, скорректированная версия доступна для новых сабитов. Для получения актуальных значений итоговой метрики и позиций в конкурсном списке просим сделать ре-сабмит ваших решений. Для этого мы временно увеличиваем суточный лимит по максимальному кол-ву сабитов до 3 шт. в сутки. Повышение лимита будет действовать до 08.10.2026 включительно.
4
@hermann542230 сентября
Добрый день, а когда обновится счётчик? Или надо дождаться обновления по таймеру?
1
@conn444530 сентября
Здравствуйте, а где можно посмотреть запись разбора задачи?
3
@schoen19931 октября
Здравствуйте!
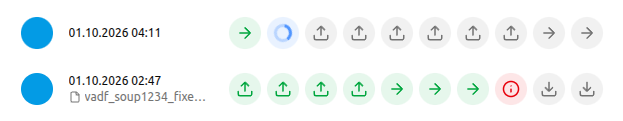
С 01.10.2026 02:11мск скрипт висит на этапе 02. Статус очистки дискового пространства
2
@blick86241 октября
Здравствуйте! Обратите внимание, что в архив с весами модели не следует добавлять датасеты, изображения и другие вспомогательные данные, не необходимые для запуска решения.
В загруженном архиве вместе с весами содержался датасет с большим количеством отдельных файлов изображений. В результате при распаковке был превышен лимит inode на хосте инференса.
Пожалуйста, оставляйте в архиве только файлы, необходимые для запуска модели: веса, конфигурацию и иные обязательные для инференса файлы. Датасеты, кэши, логи и прочие промежуточные данные необходимо исключить из архива.
0
@schoen19931 октября
@blick8624
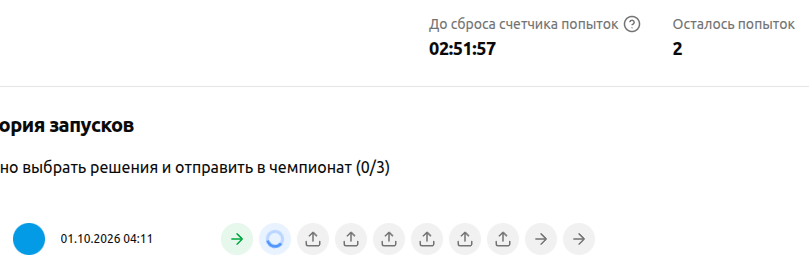
Принято. Вы меня с кем-то спутали, у меня изображений нет. 19 файлов в 3х директориях. Решение не подхватилось и 24 часа нельзя было отправить другое, пока таймер суточный не истек. В других ветках 29-31 про такое тоже писали.
Screenshot from 2026-10-01 21-56-02.png
png (13 Kb)
Screenshot from 2026-10-02 01-20-16.png
png (23 Kb)
0
@schoen19931 октября
Очень неудобно, что для разных конкурсов одна очередь загрузки. Файлы уезжают вниз, не выбрать (или я не вижу как это сделать), с тем же именем повторно не загрузить и чтобы повторно запустить решение после фикса VLA приходится файлы переименовывать/собирать заново. Да и неудачные нельзя удалить /
0
 @bins6237
2 октября
Здравствуйте. Три запуска моего решения упали на этапе «12. Статус работы скрипта оценки решения»:
01.10 20:39 vla_base_001_submission.zip
02.10 06:48 vla_base_001_submission.zip
02.10 07:22 vla_base_001_submission_v2.zip
Контрольный архив submission (1).zip с той же структурой успешно прошёл 01.10 13:11. В новом архиве отсутствуют изображения, датасеты, кэши и логи; размер 3.45 ГБ.
Можете предоставить, пожалуйста, лог упавшего запуска.
0
@bins62374 октября
А будет какой-то ответ? Я не могу ни один ответ загрузить.
0
@schoen19934 октября
Возьми конфиг как у организаторов(там пути жестко зашиты), поменяй только модель
0
@conn44454 октября
Здравствуйте! Хотели бы уточнить несколько моментов по обучению action expert.
1. Объём обучающих данных. В ответе от 24.09 было указано, что для обучения VLA можно использовать весь доступный датасет LIBERO v3.0 и менять размер выборки через vla_libero.yaml. Предоставленный HuggingFaceVLA/libero @ v3.0 содержит 40 задач и 1693 эпизода из четырёх целевых сьютов. Можно ли дополнительно использовать демонстрации других задач LIBERO, например libero_90, если привести их к тому же формату и обеспечить полную воспроизводимость пайплайна? Или обучение должно проводиться исключительно на предоставленном датасете v3.0?
2. Аугментации изображений. В LeRobot есть стандартные преобразования обучающих кадров через dataset.image_transforms: изменение яркости, контраста, насыщенности, оттенка, резкости, случайный crop и т. д. Допустимо ли использовать такие аугментации при обучении action expert, если их параметры будут явно указаны в описании решения?
3. Формулировки инструкций. Можно ли при обучении использовать перефразированные текстовые инструкции для задач из LIBERO v3.0, сохраняя исходный смысл задачи? Генерация перефразировок при этом будет офлайн и воспроизводимой, а сами эпизоды, действия и изображения останутся без изменений.
И ещё хотели бы подтвердить один момент: правильно ли мы понимаем, что chunk_size, как и n_action_steps, можно менять при обучении политики, поскольку это параметр конфигурации модели, изменение которого не меняет форму обучаемых весов?
2
@ferry35636 октября
Добрый день!
1) Дополнять нельзя, обучение должно проводиться исключительно на предоставленном датасете v3.0.
2) Аугментации использовать не допускается.
3) Перефразировать инструкции тоже не допускается.
В общем, можно использовать только предоставленный датасет v3.0 без каких либо изменений.
По chunk_size и n_action_steps все верно, менять при обучении политики их можно.
0
 @konopelski2330
5 октября
Добрый день! Сегодня у нас два сабмита подряд (04.10 16:39 и 21:14) упали на «12. Статус работы скрипта оценки решения». При этом сабмит от 04.10 03:18 с той же структурой архива прошёл (10.0253). Отличия упавших от прошедшего: только веса action_expert (обучен на полном HuggingFaceVLA/libero, 30k шагов вместо mini-фикстуры) и пути/число шагов в конфигах. Мы проверили веса: NaN/Inf нет во всех safetensors, структура тензоров байт-в-байт совпадает с прошедшим сабмитом, VLM-веса идентичны. Похоже на проблему оценщика после сегодняшнего фикса — проверьте, пожалуйста, логи запусков 16:39 и 21:14 (аккаунт konopelski2330). Если нужен наш архив для воспроизведения — пришлём.
0
@blick86245 октября
Здравствуйте, убедитесь, что все веса у вас есть локально, структура сабмита сооветствует требованиям и в конфигах нет ссылок на загрузку чего либо с Hugginface
0
@schoen19937 октября
Здравствуйте, после просмотра вебинара и вчерашнего ответа @ferry3563 возникли вопросы.
1. Ответом от 06.10 @ferry3563 закреплено обучение action-эксперта только на LIBERO v3.0 без изменений. Разрешено ли дополнительно к демонстрациям v3.0 обучать action-эксперт на траекториях, сгенерированных нами в предоставленном симуляторе LIBERO на задачах из v3.0, при полном коде/сидах/логах и доступности всех компонентов организаторам?
2. Разрешена ли инициализация action-эксперта (или использование как учителя) от публичных open-source чекпойнтов SmolVLA-моделей, обученных третьими лицами на LIBERO?
3. Ограничение v3.0 касается обучения action-эксперта? VLM-компонент строится на предоставленном для generate_dataset сырье с нашей автоматической разметкой? Просим уточнить структуру этого сырья.
0
@konopelski23309 октября
Здравствуйте! Просим уточнить правила использования готовой сторонней разметки на стадии дообучения SmolVLM2.
Разрешено ли использовать опубликованные сторонними авторами открытые аннотации (например, Embodied-CoT/ECoT для BridgeData2), если отбирать только аннотации к эпизодам четырёх источников со вкладки «Данные» и указанных там версий, без добавления посторонних изображений или видео?
Предполагается, что лицензия допускает такое использование, источник и версия разметки фиксированы, все необходимые файлы доступны организаторам, а generate_dataset.py офлайн и воспроизводимо сопоставляет, фильтрует и преобразует готовые аннотации в ShareGPT JSONL. Речь только о VLM-датасете; данные обучения action-эксперта LIBERO v3.0 не изменяются.
Допустим ли такой вариант, или дополнительную разметку необходимо заново генерировать из предоставленного сырья, без импорта готовых сторонних аннотаций?
0
@trantow23379 октября
Обращаю внимание, что форма по-прежнему даёт грузить три сабмита в сутки.
-2